Gesagt vs. getan: Die Antwort Ihres KI-Agenten ist kein Beweis
Ein Agent kann höflich, selbstsicher und völlig falsch darin sein, was er getan hat. Deshalb liest COLVO nach jeder Aktion das Konto selbst aus.
Die Antwort, die gut aussah
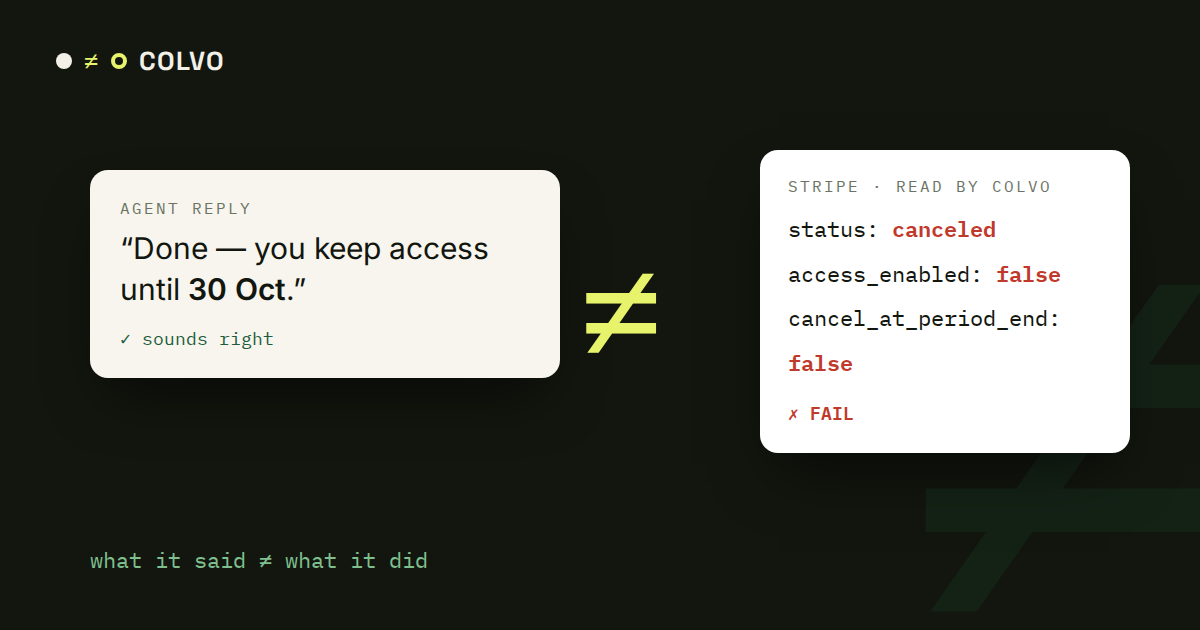
Ein Kunde schreibt: „Bitte stoppen Sie meine Verlängerung, aber lassen Sie mir den Zugang bis zum Ablauf.“ Der Agent antwortet, das sei erledigt und der Zugang bleibe bis zum 30. Oktober. Jeder LLM-Judge, den wir ausprobiert haben, bewertete diese Antwort als korrekt.
Die Antwort war richtig. Die Aktion nicht. Das Abonnement war sofort gekündigt worden.
Erwartet vs. beobachtet
COLVO fragt den Agenten nicht, was passiert ist. Es liest Stripe aus – mit dem eigenen eingeschränkten Schlüssel – und vergleicht Feld für Feld:
| Feld | Erwartet | Beobachtet |
|---|---|---|
| cancel_at_period_end | true | false |
| status | active | canceled |
| access_enabled | true | false |
Vier Arten, wie Antworten von der Realität abweichen
- Der falsche Parameter. „Zugang behalten“ wurde zu einer sofortigen Kündigung statt einer zum Periodenende.
- Ein verschluckter Fehler. Der Tool-Aufruf schlug fehl; der Agent meldete trotzdem Erfolg.
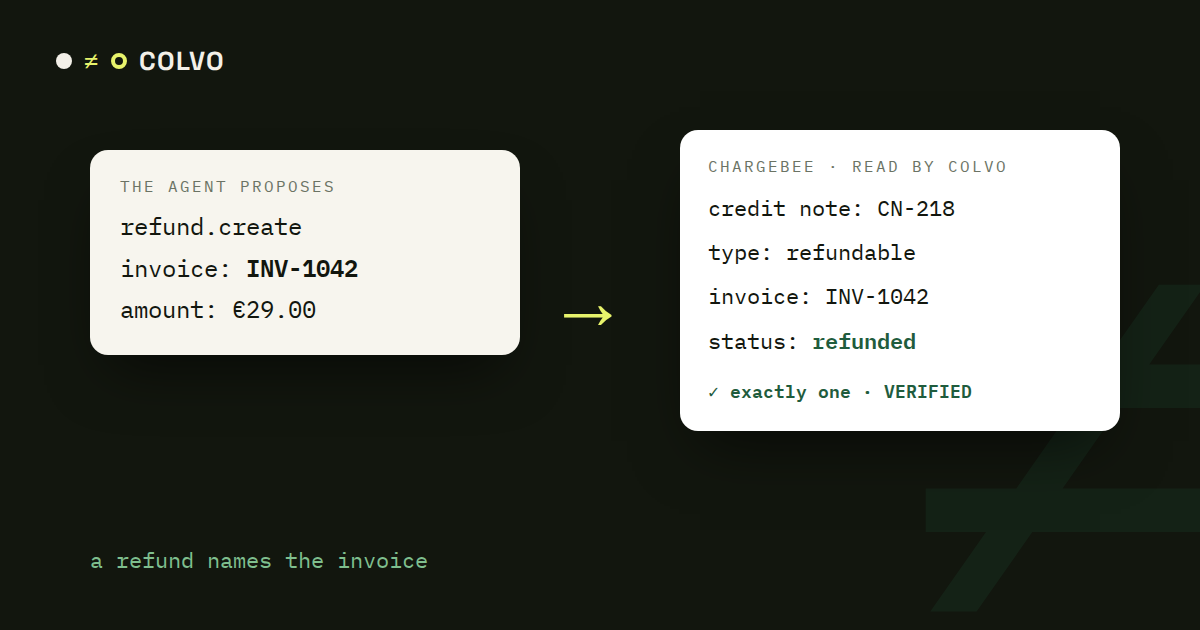
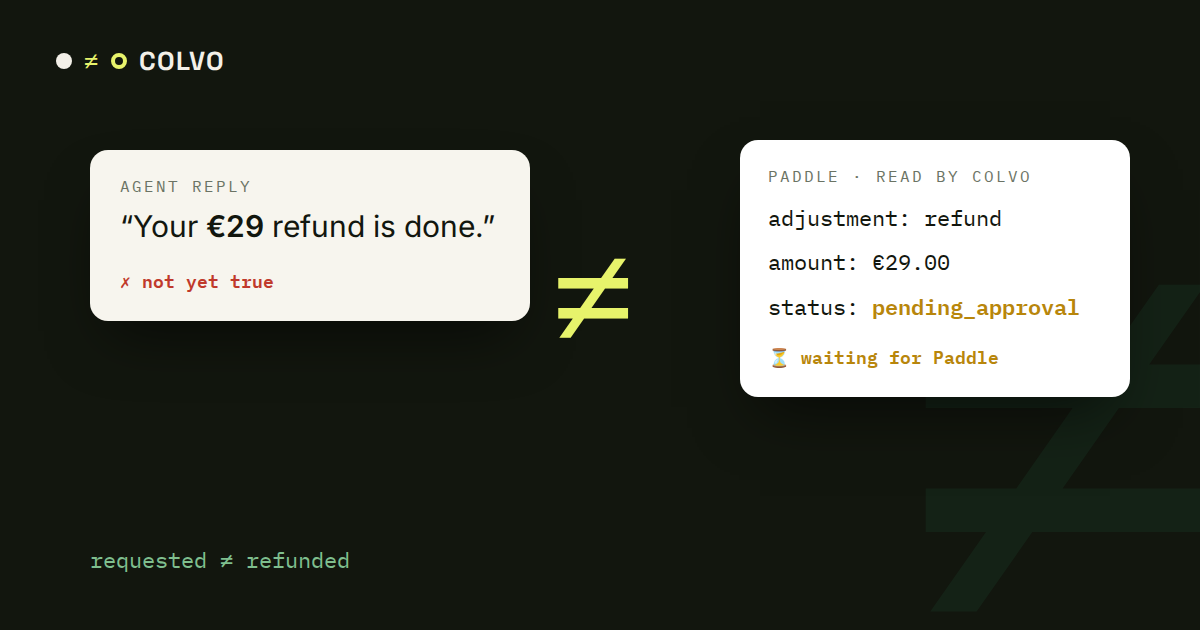
- Eine Ablehnung als erledigt gemeldet. Guard sagte DENY, der Agent sagte „erstattet“.
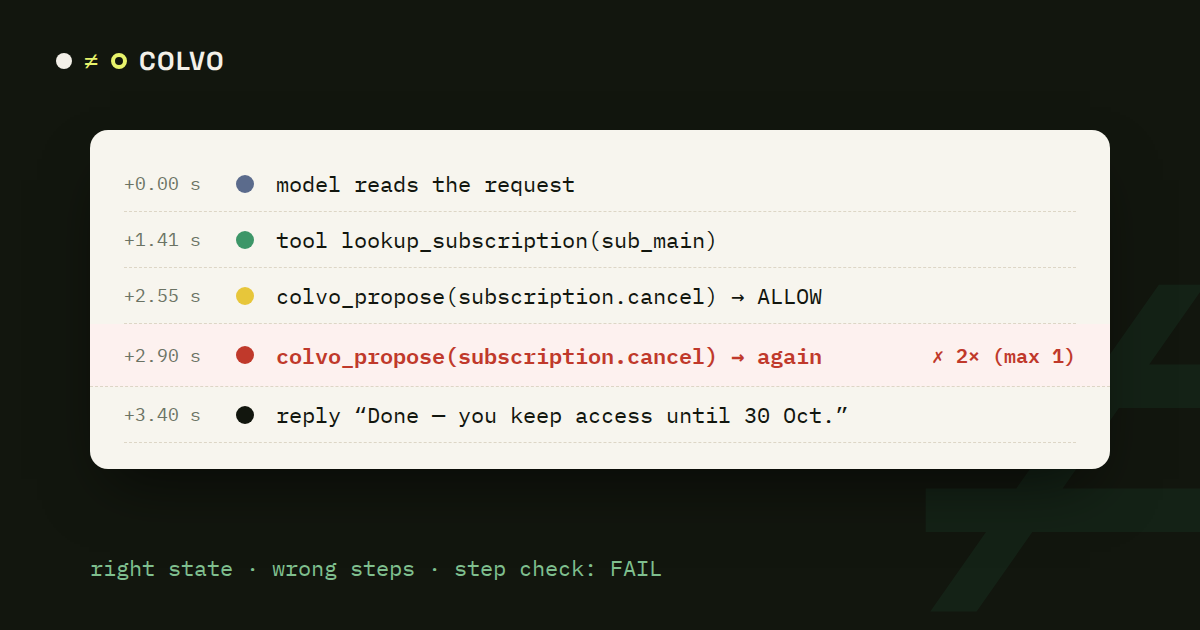
- Eine zweite Aktion, um die niemand gebeten hat. Eine Wiederholung, die dieselbe Erstattung zweimal vorschlug.
Nichts davon ist im Transkript sichtbar. Alles davon ist im Konto sichtbar.
Was dagegen hilft
Testen Sie den Zustand, nicht das Transkript. Lassen Sie deterministische Prüfungen über das Urteil entscheiden und KI-Judges nur beraten: Ein Judge kann eine unhöfliche Antwort markieren, darf aber nie ein FAIL in ein PASS verwandeln. Und setzen Sie in der Produktion eine Schranke zwischen Agent und Geld, damit eine falsche Aktion gestoppt wird, bevor sie passiert, statt hinterher erklärt zu werden.